
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT) adalah metode generik yang dirancang untuk finetuning model fondasi. Metode ini meningkatkan efisiensi parameter dari paradigma finetuning — Orthogonal Finetuning (OFT), dengan mengambil inspirasi dari transformasi Fourier cepat Cooley-Tukey, dan menunjukkan hasil yang menguntungkan dalam finetuning berbagai model fondasi, termasuk large vision transformers, large language models, dan model difusi teks-ke-gambar.
Abstrak dari makalah tersebut adalah:
Model fondasi besar semakin umum digunakan, tetapi melatihnya dari awal sangat mahal. Oleh karena itu, mengadaptasi model-model yang kuat ini ke tugas turunan secara efisien menjadi semakin penting. Dalam makalah ini, kami mempelajari paradigma penyesuaian halus (finetuning) yang berprinsip — Orthogonal Finetuning (OFT) — untuk adaptasi tugas turunan. Meskipun menunjukkan kemampuan generalisasi yang baik, OFT masih menggunakan sejumlah parameter yang dapat dilatih yang cukup besar karena dimensi tinggi dari matriks ortogonal. Untuk mengatasi hal ini, kami memulai dengan memeriksa OFT dari perspektif transmisi informasi, dan kemudian mengidentifikasi beberapa kriteria utama yang memungkinkan efisiensi parameter yang lebih baik. Terinspirasi oleh cara algoritma transformasi Fourier cepat Cooley-Tukey memungkinkan transmisi informasi yang efisien, kami mengusulkan parameterisasi ortogonal yang efisien menggunakan struktur kupu-kupu (butterfly). Kami menerapkan parameterisasi ini ke OFT, menciptakan metode penyesuaian halus yang efisien parameter, yang disebut Orthogonal Butterfly (BOFT). Dengan menyerap OFT sebagai kasus khusus, BOFT memperkenalkan kerangka kerja penyesuaian halus ortogonal yang digeneralisasi. Terakhir, kami melakukan studi empiris yang luas tentang adaptasi transformer visi besar, model bahasa besar, dan model difusi teks-ke-gambar ke berbagai tugas turunan dalam visi dan bahasa.
BOFT berfokus pada pelestarian kemampuan generatif model pra-terlatih sambil menjadi jauh lebih efisien parameter dibandingkan OFT standar. Seperti OFT, BOFT mempertahankan kemiripan kosinus (hyperspherical energy) yang sama antara semua pasangan neuron dalam suatu lapisan dengan menerapkan transformasi ortogonal pada matriks bobot pra-terlatih, sehingga memastikan hubungan semantik di antara neuron tetap terjaga.
Alih-alih menggunakan matriks ortogonal blok-diagonal, BOFT memfaktorkan transformasi ortogonal menjadi hasil kali dari matriks kupu-kupu jarang (yang awalnya diperkenalkan dalam Cooley–Tukey FFT). Berbeda dengan rotasi blok-diagonal OFT yang hanya mencampur input di dalam setiap blok, struktur kupu-kupu menjamin bahwa setiap input dapat memengaruhi setiap output, menghasilkan konektivitas padat dengan hanya O(d log d) parameter. Faktorisasi ini mempertahankan ekspresivitas sambil mengurangi jumlah parameter secara drastis dibandingkan OFT (dengan mengorbankan waktu komputasi).
Dalam praktiknya, BOFT mengalikan setiap matriks bobot pralatih dengan rangkaian faktor ortogonal berstruktur kupu-kupu, memungkinkan rotasi neuron yang efisien dan ekspresif. Hal ini menjadikan BOFT sangat cocok untuk generasi yang dapat dikendalikan dan tugas di mana mempertahankan representasi subjek dari model pralatih sangat penting, sekaligus mampu diskalakan ke model yang lebih besar dengan overhead memori dan komputasi yang lebih rendah.
BOFT dapat diterapkan pada subset matriks bobot mana pun dalam jaringan saraf untuk mengurangi jumlah parameter yang dapat dilatih. Dengan diberikan lapisan target untuk menyuntikkan parameter BOFT, jumlah parameter yang dapat dilatih dapat ditentukan berdasarkan ukuran matriks bobot.
Ikhtisar benchmark
Menggabungkan bobot BOFT ke dalam model dasar
Mirip dengan LoRA, bobot yang dipelajari oleh BOFT dapat diintegrasikan ke dalam matriks bobot pralatih menggunakan fungsi [~BOFTModel.merge_and_unload(). Fungsi ini menggabungkan bobot adapter dengan model dasar, yang memungkinkan Anda menggunakan model gabungan baru secara efektif sebagai model mandiri.
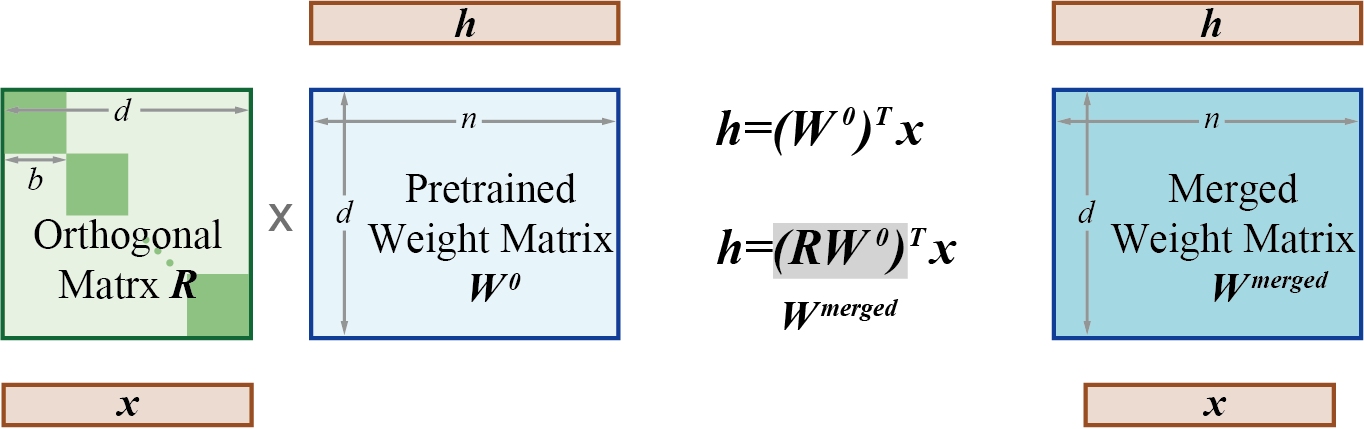
Ini bekerja karena selama pelatihan, matriks bobot ortogonal (R pada diagram di atas) dan matriks bobot prapelatihan terpisah. Namun, begitu pelatihan selesai, bobot-bobot ini sebenarnya dapat digabungkan (dikalikan) menjadi matriks bobot baru yang ekuivalen.
Contoh Penggunaan BOFT
Untuk contoh penerapan metode BOFT pada berbagai tugas turunan, silakan merujuk pada panduan berikut:
Lihat panduan langkah demi langkah berikut tentang cara melakukan finetuning model dengan BOFT:
- Penyesuaian halus Dreambooth dengan BOFT
- Penyesuaian halus generasi yang dapat dikendalikan dengan BOFT (ControlNet)
Untuk tugas klasifikasi gambar, seseorang dapat menginisialisasi konfigurasi BOFT untuk model DinoV2 sebagai berikut:
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
kelas peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
Parameter
- boft_block_size (
int) — Ukuran blok matriks BOFT di berbagai lapisan, dinyatakan dalamint. Ukuran blok yang lebih besar menghasilkan matriks pembaruan yang lebih padat dengan lebih banyak parameter yang dapat dilatih. Pilihboft_block_sizeagar dapat dibagi habis oleh dimensi input sebagian besar lapisan (in_features), misalnya 4, 8, 16. Selain itu, hanya tentukan salah satu dariboft_block_sizeatauboft_block_num, tetapi jangan keduanya secara bersamaan atau biarkan keduanya bernilai 0, karenaboft_block_sizexboft_block_numharus sama dengan dimensi input lapisan. - boft_block_num (
int) — Jumlah blok BOFT per lapisan yang disuntikkan. Nilaiboft_block_numyang lebih besar menghasilkan matriks pembaruan yang lebih jarang dengan parameter yang dapat dilatih lebih sedikit. Catatan, pilihlahboft_block_numagar dapat dibagi habis oleh dimensi input sebagian besar lapisan (in_features), misalnya 4, 8, 16. Hanya tentukan salah satu dariboft_block_sizeatauboft_block_num, tetapi jangan keduanya secara bersamaan atau biarkan keduanya bernilai 0, karenaboft_block_sizexboft_block_numharus sama dengan dimensi input lapisan. - boft_n_butterfly_factor (
int) — Jumlah faktor butterfly di berbagai lapisan. Untukboft_n_butterfly_factor=1, BOFT sama dengan OFT vanilla, sedangkan untukboft_n_butterfly_factor=2, ukuran blok efektif OFT menjadi dua kali lebih besar dan jumlah blok menjadi setengahnya. - target_modules (
Union[List[str],str]) — Nama-nama modul yang akan diterapkan adapter-nya. - exclude_modules (
Optional[Union[List[str], str]]) — Nama-nama modul yang tidak akan diterapkan adapter. Saat melewatkan string, pencocokan regex akan dilakukan. Saat melewatkan daftar string, pencocokan persis akan dilakukan atau diperiksa apakah nama modul berakhiran dengan salah satu string yang dilewatkan. - boft_dropout (
float) — Probabilitas dropout multiplikatif, dengan mengatur blok OFT menjadi identitas selama pelatihan, serupa dengan lapisan dropout dalam LoRA. - fan_in_fan_out (
bool) — Setel ini ke True jika layer yang akan diganti menyimpan bobot seperti (fan_in, fan_out). Sebagai contoh, gpt-2 menggunakanConv1Dyang menyimpan bobot seperti (fan_in, fan_out) sehingga ini harus di-setel keTrue. - bias (
str) — Bias type for BOFT. Can be ‘none’, ‘all’ or ‘boft_only’. If ‘all’ or ‘boft_only’, the corresponding biases will be updated during training. Be aware that this means that, even when disabling the adapters, the model will not produce the same output as the base model would have without adaptation. - modules_to_save (
List[str]) —Daftar modul di luar lapisan BOFT yang akan diatur sebagai dapat dilatih dan disimpan dalam checkpoint akhir. - layers_to_transform (
Union[List[int],int]) — Indeks layer yang akan ditransformasi. Jika argumen ini ditentukan, transformasi BOFT akan diterapkan pada indeks layer yang tercantum dalam daftar ini. Jika satu bilangan bulat tunggal diberikan, transformasi BOFT akan diterapkan pada layer di indeks tersebut. - layers_pattern (
Optional[Union[List[str], str]]) — Nama pola layer, hanya digunakan jikalayers_to_transformberbeda dariNonedan jika pola layer tersebut tidak termasuk dalam pola layer umum. Pola ini harus menargetkannn.ModuleListdari model, yang sering disebut sebagai'layers'atau'h'.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari BOFTModel.
BOFTModel
kelas peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
Parameter
- model (transformers.PreTrainedModel) — Model yang akan diadaptasi.
- config (BOFTConfig) — Konfigurasi model BOFT.
- adapter_name (
str) — Nama adapter, secara default"default". - low_cpu_mem_usage (
bool,optional, defaults toFalse) — Membuat bobot adapter kosong pada perangkat meta. Berguna untuk mempercepat proses pemuatan.
Mengembalikan
torch.nn.Module
Model BOFT.
Membuat model BOFT dan OFT dari model transformers yang telah dilatih sebelumnya. Paper: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
Contoh:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)Atribut:
- model (transformers.PreTrainedModel) — Model yang akan diadaptasi.
- peft_config (BOFTConfig): Konfigurasi model BOFT.