
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO هو معيار مصمم لدراسة التعلم الروبوتي مدى الحياة — وهو المفهوم الذي ينص على أن الروبوتات تحتاج إلى مواصلة التعلم والتكيف مع مستخدميها بمرور الوقت، وليس مجرد تدريب مسبق مرة واحدة. يوفر مجموعة من مهام التلاعب القياسية التي تركز على نقل المعرفة: مدى قدرة الروبوت على تطبيق ما تعلمه بالفعل على مواقف جديدة. من خلال التقييم على LIBERO، يمكن مقارنة الخوارزميات المختلفة بشكل عادل ويمكن للباحثين البناء على أعمال بعضهم البعض.
- الورقة: قياس معايير نقل المعرفة للتعلم الروبوتي المستمر
- GitHub: Lifelong-Robot-Learning/LIBERO
- موقع المشروع: libero-project.github.io
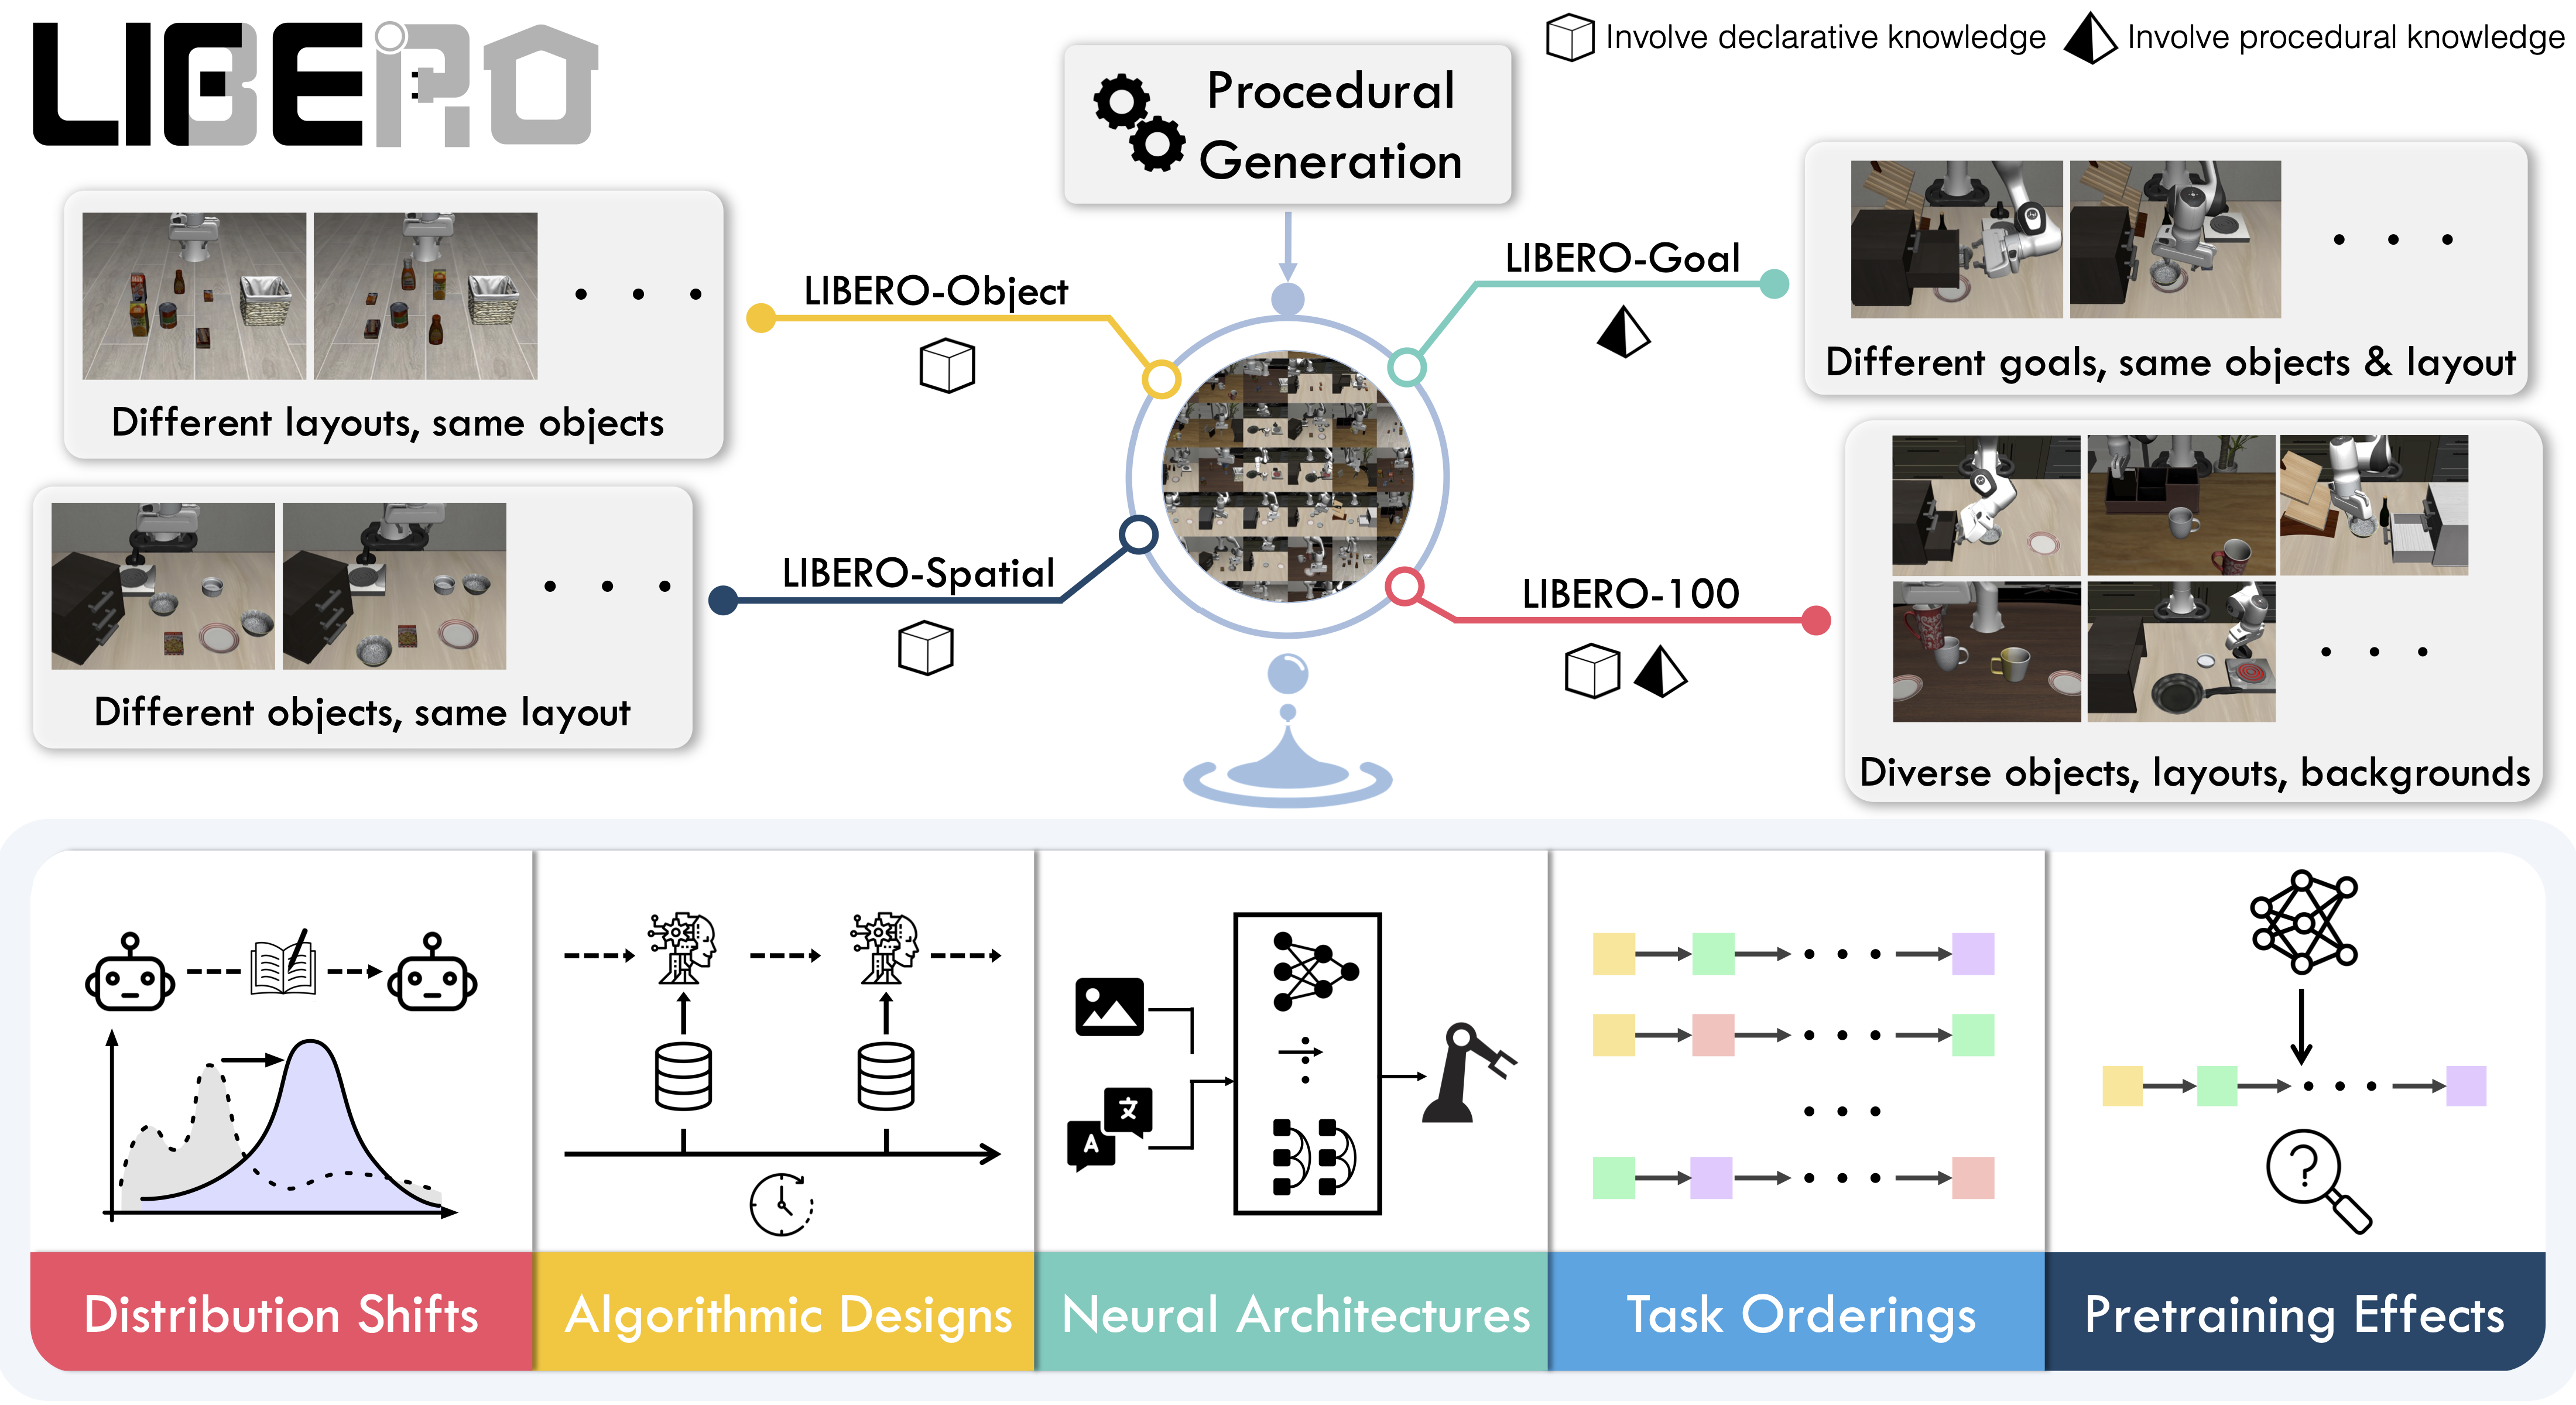
المهام المتاحة
يتضمن LIBERO خمسة مجموعات مهام تغطي 130 مهمة، بدءًا من التلاعب البسيط بالأشياء وصولًا إلى سيناريوهات متعددة الخطوات معقدة:
| Suite | اسم سطر الأوامر | المهام | الوصف |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | المهام التي تتطلب الاستدلال حول العلاقات المكانية |
| LIBERO-Object | libero_object | 10 | مهام تركز على التلاعب بأشياء مختلفة |
| LIBERO-Goal | libero_goal | 10 | مهام مشروطة بهدف بأهداف متغيرة |
| LIBERO-90 | libero_90 | 90 | مهام قصيرة المدى من مجموعة LIBERO-100 |
| LIBERO-Long | libero_10 | 10 | مهام طويلة المدى من مجموعة LIBERO-100 |
التثبيت
بعد اتباع تعليمات تثبيت LeRobot:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
التقييم
التقييم المحلي الافتراضي
قيّم عبر المجموعات القياسية الأربع (10 حلقات لكل مهمة):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
التقييم في مجموعة واحدة
التقييم على مجموعة LIBERO واحدة:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.taskيختار المجموعة (libero_object،libero_spatial، إلخ).--env.task_idsيقيّد التنفيذ على فهارس مهام محددة ([0]،[1,2,3]، إلخ). يُستثنى ذلك لتشغيل جميع المهام في المجموعة.- يتحكم
--eval.batch_sizeفي عدد البيئات التي تعمل بالتوازي. --eval.n_episodesيحدد عدد الحلقات التي يجب تشغيلها لكل مهمة.
التقييم متعدد الحزم
قم بإجراء اختبار أداء لسياسة عبر عدة مجموعات في وقت واحد عن طريق تمرير قائمة مفصولة بفواصل:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
وضع التحكم
يدعم LIBERO وضعَي تحكم — relative (الافتراضي) وabsolute. تُدرَّب نقاط التفتيش المختلفة لـ VLA باستخدام معاملات إجراء مختلفة، لذا تأكد من أن الوضع يتطابق مع سياستك:
--env.control_mode=relative # or "absolute"إعادة تعيين الأداء
بشكل افتراضي، يحافظ LeRobot على سلوك إعادة الضبط الصلبة (hard-reset) الخاصة بـ LIBERO. عند تمكين الحالات الأولية الثابتة، يمكنك اختيار إعادة الضبط الناعمة (soft resets) لتجاوز إعادة بناء نموذج المحاكاة وعارض العرض في كل حلقة:
--env.init_states=true --env.hard_reset=falseتكون إعادة الضبط الناعمة أسرع، لكنها لا تطابق إعادة الضبط الصلبة على مستوى البتات بعد خطوات استقرار البيئة، لذا قد تختلف ملاحظات الكاميرا ونتائج السياسة اختلافًا طفيفًا. استخدم إعادة الضبط الصلبة عند إعادة إنتاج نتائج المعايير.
مدخلات ومخرجات السياسة
الملاحظات:
observation.state— ميزات حسّية ذاتية (proprioceptive) بأبعاد 8 (موضع طرف الإجراء، الاتجاه بصيغة المحور-الزاوية، موضع قبضة الماسك)observation.images.image— عرض الكاميرا الرئيسي (agentview_image)، HWC uint8observation.images.image2— عرض كاميرا المعصم (robot0_eye_in_hand_image)، HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
الإجراءات:
- التحكم المستمر في
Box(-1, 1, shape=(7,))— دلتا طرف النهاية ثلاثية الأبعاد + قابض أحادي البعد
حلقات التقييم الموصى بها
لإجراء تقييمات قابلة للتكرار، استخدم 10 حلقات لكل مهمة عبر جميع المجموعات القياسية الأربع (Spatial وObject وGoal وLong). يمنح ذلك 400 حلقة إجمالاً ويتوافق مع البروتوكول المستخدم للنتائج المنشورة. قد تختلف معدلات النجاح بنسبة مئوية قليلة عبر بذور التقييم المختلفة، لذا نوصي بمتوسط 3 بذور.
يقدم lerobot-eval فترة ويلسون بنسبة 95% (pc_success_ci95) بجانب كل معدل نجاح. عند 10 حلقات، يكون نطاق المهمة التي حصلت على 9/10 تقريبًا من 60% إلى 98%، بينما يكون نطاق إجمالي مجموعة من 400 حلقة بنسبة 80% تقريبًا من 76% إلى 84%. إذا تداخلت فترتا سياسة على مهمة معينة، فإن ذلك لا يُثبت اختلافهما على تلك المهمة في تلك الجولة. تغطي الفترة الحلقات التي تم اختيارها؛ لكنها لا تغطي بذرة التدريب للسياسة، والتي تتطلب أكثر من جولة تدريب واحدة لقياسها.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
التدريب
مجموعة البيانات
تتوافق مجموعتا بيانات LIBERO المُعالجتان مسبقًا بشكل كامل مع LeRobot. تحتويان على نفس العروض التوضيحية بنفس المخطط، وتختلفان في طريقة تخزين إطارات الكاميرا:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| الحلقات / الإطارات / المهام | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| كاميرات | 2× 256×256×3 | 2× 256×256×3 |
| أبعاد الحالة / الإجراء | 8 / 7 | 8 / 7 |
| تنسيق مجموعة البيانات | v3.0 | v3.0 |
| ترميز الكاميرا | فيديو MP4 | PNG في parquet |
| حجم التحميل | 1.9 GB | 69.9 GB |
| اعتماد إضافي | واجهة الخلفية للفيديو (torchcodec أو pyav) | none |
نوصي بـ lerobot/libero: تحميل أصغر بحوالي 37 مرة مع سرعة تحميل مكافئة (حوالي 330 عينة/ثانية لكل عامل). إعادة ترميز الفيديو خاسرة قليلاً؛ استخدم النسخة القائمة على الصور إذا لم تتمكن من تثبيت خلفية لفك ترميز الفيديو.
للاستئناس، مجموعة البيانات الأصلية التي نشرتها Physical Intelligence:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
مثال على أمر التدريب
درّب SmolVLA على مجموعة البيانات الموصى بها:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
لمشاركة النتيجة على Hub، استبدل --policy.push_to_hub=false بـ --policy.repo_id=${HF_USER}/libero-smolvla. قيّم نقاط التفتيش المحفوظة باستخدام lerobot-eval كما هو موضح في قسم التقييم.
إعادة إنتاج النتائج المنشورة
نعيد إنتاج نتائج Pi0.5 على معيار LIBERO. نأخذ النموذج الأساسي لـ LIBERO من Physical Intelligence (pi05_libero) ونقوم بتدريبه الدقيق لـ 6 آلاف خطوة إضافية في bfloat16، مع حجم دفعة يبلغ 256 على 8 وحدات معالجة رسومية H100 باستخدام مجموعة بيانات LIBERO من HuggingFace.
النموذج المُحسَّن: lerobot/pi05_libero_finetuned
أمر التقييم
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
قمنا بإعداد n_action_steps=10 بما يتوافق مع التنفيذ الأصلي لـ OpenPI.
النتائج
| النموذج | LIBERO المكانية | LIBERO Object | هدف LIBERO | LIBERO 10 | المتوسط |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
تتوافق هذه النتائج مع النتائج الأصلية التي أبلغ عنها Physical Intelligence:
| النموذج | LIBERO المكانية | LIBERO Object | هدف LIBERO | LIBERO 10 | المتوسط |
|---|---|---|---|---|---|
| باي 0.5 (أوبن بي آي) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |